2025 年 LLM 年度回顾
本文目录
2025 年是 LLM 取得强劲进展、事件频发的一年。以下是一份个人认为值得注意、且略感意外的“范式转变”清单——那些改变了格局、在概念上令我印象深刻的事情。
1. 基于可验证奖励的强化学习(Reinforcement Learning from Verifiable Rewards, RLVR)#
2025 年初,所有实验室的 LLM 生产栈大致是这样的:
- 预训练(约 2020 年的 GPT-2/3)
- 监督微调(约 2022 年的 InstructGPT)
- 基于人类反馈的强化学习(Reinforcement Learning from Human Feedback, RLHF,约 2022 年)
这在一段时间内是训练生产级 LLM 稳定且经过验证的配方。到了 2025 年,基于可验证奖励的强化学习(RLVR)成为事实上应当加入这一组合的新的重要阶段。通过在一系列环境(例如数学和代码谜题)中,依据自动可验证的奖励来训练 LLM,LLM 会自发地发展出在人类看来像“推理”的策略——它们学会把问题求解拆解为中间计算,并学会若干来回推敲、弄清问题的求解策略(示例见 DeepSeek R1 论文)。这些策略在先前的范式中很难实现,因为对于 LLM 来说,最优的推理轨迹和纠错路径并不明确——它必须通过针对奖励的优化,找到适合自己的方式。
与 SFT 和 RLHF 阶段不同——这两个阶段相对较薄、较短(在计算量上只是小幅微调)——RLVR 针对客观(不可被钻空子)的奖励函数进行训练,因而可以优化长得多的时间。运行 RLVR 被证明能带来很高的能力/美元(capability/$)比,它吞噬了原本计划用于预训练的计算。因此,2025 年的大部分能力进步,是由 LLM 实验室消化这一新阶段的“势能过剩(overhang)”所定义的,总体而言,我们看到的是规模相近的 LLM,但 RL 训练时长远长得多。这个新阶段还有一个独特之处:我们得到了一个全新的旋钮(以及相关的扩展定律),可以通过生成更长的推理轨迹、增加“思考时间”,来控制能力随测试时计算量(test time compute)的变化。OpenAI o1(2024 年末)是 RLVR 模型的最早演示,但 o3 的发布(2025 年初)显然是拐点,在那里你能直观地感受到差异。
2. 幽灵 vs. 动物 / 参差不齐的智能(Ghosts vs. Animals / Jagged Intelligence)#
2025 年是我(我认为行业内其他人也是如此)第一次开始以更直观的方式内化 LLM 智能的“形状”。我们不是在“进化/培育动物”,我们是在“召唤幽灵”。LLM 栈的一切都不同(神经架构、训练数据、训练算法,尤其是优化压力),因此我们在智能空间中得到非常不同的实体,这并不奇怪——用动物的视角去理解它们是不合适的。从监督比特的角度看,人类神经网络是为在丛林中让部落生存而优化的,而 LLM 神经网络是为模仿人类的文本、在数学谜题中收集奖励、以及在 LM Arena 上获得人类点赞而优化的。由于可验证领域允许 RLVR,LLM 的能力在这些领域附近“突刺”,整体表现出有趣地参差不齐的性能特征——它们同时是天才式的博学者,又是困惑且认知受限的小学生,离被越狱(jailbreak)诱骗而泄露你的数据只有几秒之遥。
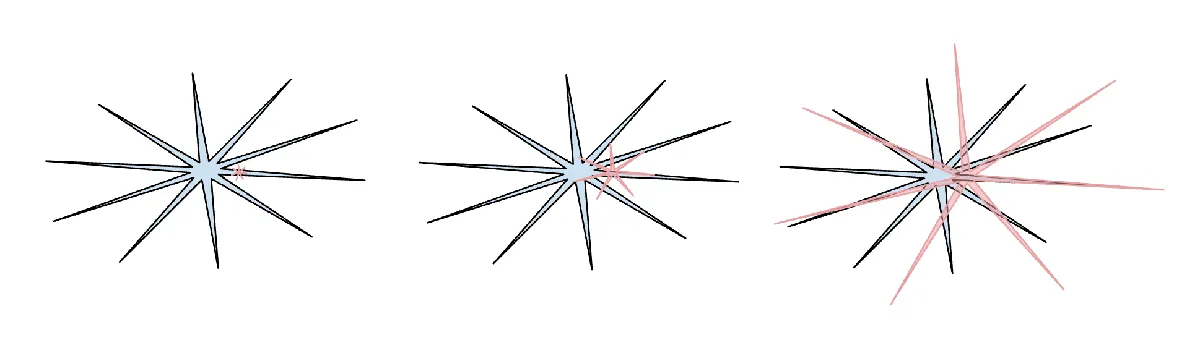
(人类智能:蓝色,AI 智能:红色。我喜欢这个梗图的这个版本(抱歉我丢失了它在 X 上原帖的引用),因为它指出人类智能也以自己不同的方式参差不齐。)
与此相关的是,我在 2025 年对基准测试(benchmarks)普遍漠然,并失去了信任。核心问题在于,基准测试几乎从构造上就是可验证环境,因此立即容易受到 RLVR 及其较弱形式(通过合成数据生成)的影响。在典型的“刷榜(benchmaxxing)”过程中,LLM 实验室的团队不可避免地会构造出与基准测试所占嵌入空间的各个小口袋相邻的环境,并长出尖刺(jaggies)去覆盖它们。在测试集上训练成了一门新的艺术形式。
碾碎所有基准测试,却仍然得不到通用人工智能(Artificial General Intelligence, AGI),那会是什么样子?
我在这里写了更多关于本节主题的内容:
3. Cursor / LLM 应用的新层#
Cursor 最令我注意的(除了它今年火箭般的崛起)是,它令人信服地揭示了“LLM 应用”的一个新层——人们开始谈论“X 的 Cursor”。正如我在今年的 Y Combinator 演讲中所强调的(文字稿 和 视频),像 Cursor 这样的 LLM 应用会为特定垂直领域打包并编排 LLM 调用:
- 它们做“上下文工程(context engineering)”
- 它们在底层编排多个 LLM 调用,串成日益复杂的有向无环图(Directed Acyclic Graph, DAG),仔细平衡性能与成本的权衡。
- 它们为人在回路中提供特定于应用的图形用户界面(Graphical User Interface, GUI)。
- 它们提供一个“自主性滑块(autonomy slider)”。
2025 年有很多讨论,关于这个新应用层有多“厚”。LLM 实验室会捕获所有应用,还是 LLM 应用仍有广阔天地?个人而言,我怀疑 LLM 实验室会倾向于“毕业”出普遍有能力的大学生,而 LLM 应用则会通过提供私有数据、传感器和执行器以及反馈回路,把它们组织、微调并真正激活成特定垂直领域中的在职专业人士。
4. Claude Code / 活在你电脑上的 AI#
Claude Code(CC)是 LLM 智能体(Agent)是什么样子的首个令人信服的演示——它以循环的方式把工具使用和推理串起来,进行长时间的问题求解。此外,CC 令我注意之处在于它运行在你的电脑上,使用你的私有环境、数据和上下文。我认为 OpenAI 在这件事上搞错了,因为他们早期 codex/agent 的工作聚焦于从 ChatGPT 编排的容器中的云端部署,而不是简单地使用 localhost。虽然云端运行的智能体集群感觉像是“AGI 终局”,但我们生活在一个能力参差不齐、起飞速度中等且足够慢的中间世界里,因此直接在开发者的电脑上运行智能体更有意义。请注意,真正重要的主要区别,不在于“AI 操作”恰好在哪里运行(云端、本地或其他),而在于其他一切——那台已经存在并已启动的电脑,它的安装、上下文、数据、密钥、配置,以及低延迟的交互。Anthropic 把这个优先级顺序搞对了,并把 CC 打包成一个令人愉悦、极简的命令行界面(Command Line Interface, CLI)形态,改变了 AI 的样子——它不再只是像 Google 那样你去访问的网站,而是“住”在你电脑上的小精灵/幽灵。这是一种全新的、独特的与 AI 交互的范式。
5. 氛围编程(Vibe coding)#
2025 年是 AI 跨过能力门槛的一年,使得仅通过英语就能构建各种令人印象深刻的程序,甚至忘了代码的存在。有趣的是,我是在这条灵光乍现的推文中创造了“vibe coding”一词,完全没料到它会走这么远 :)。借助 vibe coding,编程不再严格保留给受过高度训练的专业人士,而是任何人都能做的事。在这种意义上,它又是另一个例子,印证了我在《权力归于人民:LLM 如何改写技术扩散的剧本》中所写的观点:与迄今为止所有其他技术形成鲜明对比,普通大众从 LLM 中获益远多于专业人士、企业和政府。但 vibe coding 不仅让普通人能够接近编程,也让受过训练的专业人士能写出更多(vibe coding 出来的)软件,而这些软件原本永远不会被写出来。在 nanochat 中,我用 vibe coding 用 Rust 写了自己定制的高效 BPE(字节对编码,Byte Pair Encoding)分词器,而不必采用现有库,或把 Rust 学到那个程度。今年我用 vibe coding 做了许多项目,作为我想要其存在的东西的快速应用演示(例如见 menugen、llm-council、reader3、HN time capsule)。我还 vibe coding 了完整的临时应用,只为找到一个 bug,因为何乐而不为——代码突然变得免费、临时、可塑、用完即弃。Vibe coding 将重塑(terraform)软件,并改变职位描述。
6. Nano banana / LLM GUI#
Google Gemini Nano banana 是 2025 年最不可思议、最具范式转移意义的模型之一。在我的世界观里,LLM 是下一个主要的计算范式,类似于 1970 年代、80 年代等的计算机。因此,我们将看到类似类型的创新,原因也从根本上类似。我们将看到个人计算、微控制器(认知核心)、互联网(智能体的互联网)等等的对应物。特别是在用户界面与用户体验(User Interface and User Experience, UIUX)方面,与 LLM “聊天”有点像在 1980 年代向计算机控制台发命令。文本是计算机(和 LLM)原始、偏好的数据表示,但它不是人类偏好的格式,尤其是在输入端。人们其实不喜欢阅读文本——它缓慢且费力。相反,人们喜欢以视觉和空间方式消费信息,这就是传统计算中发明 GUI 的原因。同样,LLM 应该用我们偏好的格式与我们交流——用图像、信息图、幻灯片、白板、动画/视频、Web 应用等。当然,这一点的早期和当前版本是 emoji 和 Markdown 之类的东西,它们是通过标题、粗体、斜体、列表、表格等对文本进行“打扮”和排版,以便更容易消费的方式。但究竟谁来构建 LLM GUI?在这个世界观里,nano banana 是它可能长什么样的第一个早期暗示。重要的是,它一个值得注意的方面是,这不仅仅是图像生成本身,而是文本生成、图像生成和世界知识共同产生的联合能力,全都缠绕在模型权重之中。
太长不看(TLDR)。2025 年是 LLM 令人兴奋且略带意外的一年。LLM 正在作为一种新型智能出现,同时比我预期的聪明得多,也比我预期的笨得多。无论如何,它们极其有用,而且我认为即使在当前能力下,行业也远未意识到它们潜力的 10%。与此同时,有太多想法值得尝试,概念上这个领域感觉广阔开放。正如我今年早些时候在 Dwarkesh 播客上提到的,我同时(表面上看是矛盾的)相信:我们既会看到快速且持续的进步,又仍有大量工作要做。系好安全带。